

树的深度优先遍历 DFS:JavaScript 实现
什么是深度优先遍历
尽可能深的搜索树的分支
「尽可能深」这四个字是关键。遇到一个节点,不去看它的兄弟节点,而是先一路往子节点钻,钻到不能再深为止,然后才回退一层去处理刚才跳过的兄弟。走法上像走迷宫:一直往前走,撞墙了才退回上一个岔路口换一条路。
和广度优先的区别在于访问顺序:深度优先是一整条分支走完再换下一条,广度优先是一层走完再下一层。它们的时间复杂度都是 O(n),每个节点访问一次,差别在空间:深度优先的空间开销取决于树的高度,广度优先取决于树最宽那一层的节点数。所以对于又深又窄的树,深度优先更省内存;对于又浅又宽的树,反过来。
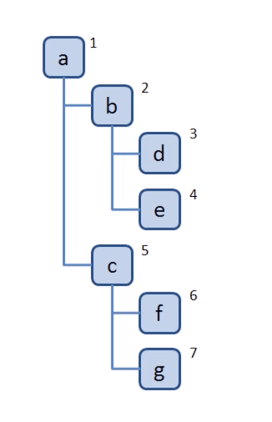
下面这张图画的是遍历的路径,可以顺着箭头看出「先深入到底、再回退换分支」的过程。
算法口诀
- 访问根节点
- 对根节点的
children挨个进行深度优先遍历
这两句就是完整的算法,值得留意的是它的递归结构:第二步要做的事情,和第一步开始做的事情是同一件事,只是对象换成了子节点。这种自我引用的定义能成立,是因为树本身就是递归定义的——每棵树的子树也是一棵树。所以深度优先遍历用递归写出来会非常短,几乎就是把这两句话直译一遍。
还有一处细节:递归的终止条件在哪?代码里看不到显式的 if 判断,因为它藏在 children 为空数组这个事实里——叶子节点的 forEach 一次都不会执行,递归自然停下。这比手写一个终止判断更简洁,但前提是每个节点的 children 字段都存在,如果数据里叶子节点压根没有这个字段,forEach 会在 undefined 上调用而报错,实际处理外部数据时要先做兜底。
const tree = {
  val: 'a',
  children: [
    {
      val: 'b',
      children: [
        {
          val: 'd',
          children: [],
        },
        {
          val: 'e',
          children: [],
        },
      ],
    },
    {
      val: 'c',
      children: [
        {
          val: 'f',
          children: [],
        },
        {
          val: 'g',
          children: [],
        },
      ],
    },
  ],
};

const dfs = root => {
  console.log(root.val);
  root.children.forEach(dfs);
};

dfs(tree);
按这棵树跑出来的输出顺序是 a、b、d、e、c、f、g。跟着走一遍:从 a 进入,先打印 a,然后进第一个孩子 b,打印 b 后又立刻往下进 d;d 是叶子,退回来处理 e;b 这一支走完才退到 a,转向第二个孩子 c,同样先 c 再 f、g。
root.children.forEach(dfs) 这一行写得很省,直接把 dfs 当回调传给 forEach。这里能这么写是因为 dfs 只用第一个参数,而 forEach 会传三个参数进来,多出来的索引和数组被忽略了。如果哪天给 dfs 加第二个参数比如记录层级深度,这种简写就会出问题——forEach 传进去的索引会跑到那个位置上。所以加参数的时候要改成 root.children.forEach(child => dfs(child, depth + 1)) 这种显式写法。
关于回退是怎么实现的:代码里没有任何显式的「退回上一层」的动作,靠的是函数调用栈。每层递归的调用帧记着自己的 forEach 走到第几个孩子了,子调用返回后自动从那里继续。这也说明递归版本的空间复杂度是 O(h),h 为树高,树太深会栈溢出。真遇到极深的树,可以改成显式用数组当栈的迭代写法:把根压进栈,循环弹出一个节点访问它,再把它的孩子倒序压回去。倒序是为了保证弹出时最左边的孩子先被处理,跟递归版的顺序一致。
还没有留言,来发表第一条吧~