

树的广度优先遍历 BFS:JavaScript 实现
什么是广度优先遍历
先访问离根节点最近的节点
换句话说是按层推进:把第一层的节点全部访问完,再去访问第二层,然后第三层。和深度优先那种一头钻到底的走法正好相反,它像水面上的涟漪,从根节点开始一圈圈向外扩散。
这个「按距离由近到远」的性质是广度优先最有价值的地方。它带来一个很强的保证:第一次访问到某个节点时,走过的路径一定是从根到它的最短路径。因为所有更近的节点都已经被访问过了,不可能存在更短的路。所以求最短路径、求最小步数这类问题,标准解法是广度优先而不是深度优先——深度优先找到的第一条路径不保证最短,得把所有路径都试完再比较。
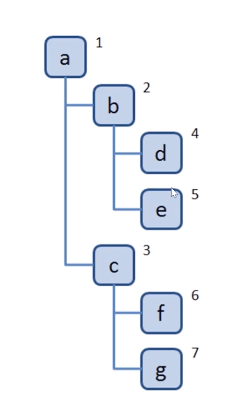
下图画的是访问顺序,可以看出它是一层一层横向铺开的。
算法口诀
- 新建一个队列,把根节点入队
- 把队头出队并访问
- 把对头的
children挨个入队 - 重复第二、三步,直到队列为空
为什么必须用队列,这里的道理值得想清楚。节点被发现的顺序,正好就是它们应该被访问的顺序——第一层的节点先被发现,它们的孩子(第二层)在处理第一层时陆续被发现,排在第一层之后。队列的先进先出恰好保持了这个顺序,所以自然形成按层访问的效果。
把队列换成栈会怎样?那就变成深度优先了。这两个算法的骨架完全一样,唯一的差别就是容器的取出顺序,这也是我觉得这两者最值得对照理解的一点。
复杂度上,每个节点入队出队各一次,时间是 O(n)。空间取决于队列中同时存在的最大节点数,也就是树最宽那一层的宽度。对于一棵满二叉树,最后一层大约占了全部节点的一半,所以最坏情况的空间是 O(n),这比深度优先递归版的 O(h) 要大。这就是前面说的取舍:宽树用深度优先省空间,深树用广度优先省空间。
const tree = {
  val: 'a',
  children: [
    {
      val: 'b',
      children: [
        {
          val: 'd',
          children: [],
        },
        {
          val: 'e',
          children: [],
        },
      ],
    },
    {
      val: 'c',
      children: [
        {
          val: 'f',
          children: [],
        },
        {
          val: 'g',
          children: [],
        },
      ],
    },
  ],
};

const bfs = root => {
  const q = [root];
  while (q.length > 0) {
    const n = q.shift();
    console.log(n.val);
    n.children.forEach(child => {
      q.push(child);
    });
  }
};

bfs(tree);
这棵树跑出来的顺序是 a、b、c、d、e、f、g,正好是逐层从左到右。跟深度优先的 a、b、d、e、c、f、g 对比一下,同一棵树、同样的数据结构,只因为容器不同就得到了两种顺序。
代码上有两点值得说。
一是它是迭代写法而不是递归。广度优先天然适合用循环表达,因为待处理的节点集合是显式存在队列里的,不需要借助调用栈来记住「还有哪些没处理」。这也意味着它不会栈溢出,处理很深的树时比递归版的深度优先更安全。
二是 q.shift() 这一行在数据量大时是性能瓶颈。shift 要把后面所有元素往前挪一位,是 O(n) 而不是 O(1),节点多的时候整体会退化到 O(n^2)。改法是不真的删元素,用一个下标当队首指针:let head = 0,取值写成 q[head++],循环条件改成 head < q.length。元素留在数组里不动,代价是空间不回收,但换来了稳定的 O(1) 出队。
最后提一个很常用的变体:上面这个写法能按层顺序访问,但拿不到「当前节点在第几层」,因为队列里混着相邻两层的节点。要区分层级,做法是在每轮循环开始时先记下 q.length,这个值就是当前层的节点数,然后只处理这么多个,处理完就是一层结束。二叉树求最大深度、按层输出、找每层最大值这类题都靠这个技巧。
还没有留言,来发表第一条吧~