

数据结构栈详解:JavaScript 实现与应用场景
什么是栈
- 一个后进先出的数据结构
Js中没有栈,但可以用Array实现栈的所有功能
后进先出常缩写成 LIFO。它的核心约束是:所有的插入和删除都只能在同一端进行,这一端习惯叫栈顶。中间的元素既取不出来也看不到,想拿到第三个元素,必须先把上面两个弹掉。
这个限制听起来是缺点,实际上正是它的价值。栈之所以有用,恰恰因为它「只能这样用」——当一个问题天然具有嵌套结构、需要按「最近打开的先关闭」的顺序处理时,栈的这个约束和问题本身的结构就对上了,代码写起来会异常简洁。括号匹配、函数调用、撤销操作,全是这个模式。
第二条说 JS 里没有栈,指的是没有专门的栈类型。但数组的 push 和 pop 正好都作用于末尾,把数组末尾当作栈顶,就得到了一个栈。代价是 Array 同时暴露了 unshift、splice、下标访问这些能力,栈的约束不是强制的,全靠自己遵守。真要严格约束,可以用类把数组包一层,只对外暴露 push、pop、peek、size 这几个方法。
复杂度方面,push 和 pop 都是 O(1),因为不涉及元素搬移,这也是为什么该用栈的时候不要用 shift 和 unshift——那两个操作在数组头部进行,需要移动后面所有元素,是 O(n)。
js 模拟栈
如下代码,先 push 1 然后 push 2,然后执行两次 pop。由于 pop 是删除数组中最后一个元素,所以 2 是先被删除的, 也就是说,2 是后被放进来的但是,最先被删掉的也是它。 可以发现这是一个后进先出示例
const stack = [];
stack.push(1);
stack.push(2);
const item1 = stack.pop();
const item2 = stack.pop();
所以 item1 拿到的是 2,item2 拿到的是 1,顺序跟放进去的时候正好相反。另外要注意栈空时继续 pop 会得到 undefined 而不是报错,自己封装栈的时候通常要加一层空栈判断,否则错误会被静默地带到后面的逻辑里。
场景
- 十进制转二进制
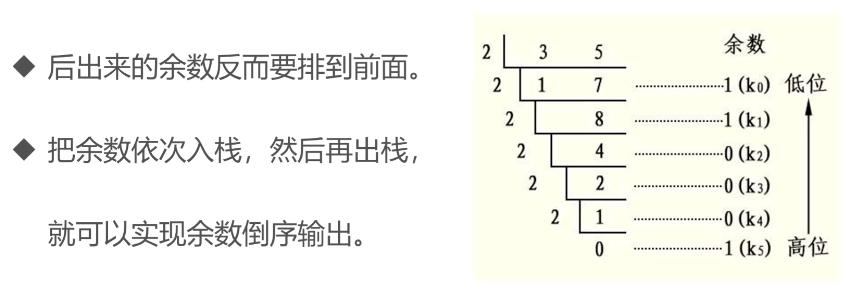
这个例子很能说明栈的适用性。十进制转二进制的算法是不断除以二取余数,但先算出来的余数是二进制的最低位,最后算出来的才是最高位,而输出时要从高位往低位写,顺序正好是反的。这时候把每次的余数压进栈,算完之后依次弹出,输出顺序自然就对了。凡是「生成顺序和使用顺序相反」的场合,栈都是最省事的解法。
下图是这个转换过程的图示,可以对照看余数的产生顺序和最终二进制位的排列顺序。
括号匹配是栈最经典的应用。三种括号可以任意嵌套,判断合法性靠的就是「最近打开的必须最先关闭」这个规则,跟栈的后进先出完全一致:遇左括号入栈,遇右括号看栈顶是否匹配。具体实现在链接那篇里。
- 函数调用堆栈
如以下代码,函数 fn1 中调用 fn2, fn2 中调用 fn3,在 js 中最先执行完的函数是 fn3 然后是 fn2、fn1, 这就满足栈的后进先出思想
这不是类比,JS 引擎内部真的维护着一个栈。每次调用函数就压入一个执行上下文,里面存着参数、局部变量、以及返回后该回到哪里继续执行;函数返回就弹出栈顶。所以调用关系再怎么嵌套,引擎都能准确地一层层回到调用点。
理解这一点有两个实际收益。一是报错时打印的调用堆栈,就是当时这个栈从栈顶到栈底的快照,最上面那一行是出错的函数,往下是逐层的调用者,看堆栈应该从上往下读。二是递归太深会抛出栈溢出错误,原因是这个栈的容量有上限,每层递归都要占一个帧,深度过大就撑爆了。所以处理深层嵌套的数据结构时,有时需要把递归改写成用显式栈的迭代版本——手动维护的栈放在堆内存里,容量比调用栈大得多。
const fn1 = () => {
  fn2();
};
const fn2 = () => {
  fn3();
};
const fn3 = () => {};

fn1();
还没有留言,来发表第一条吧~