

数据结构堆详解:最小堆的 JavaScript 实现
什么是堆
- 堆是一种特殊的完全二叉树
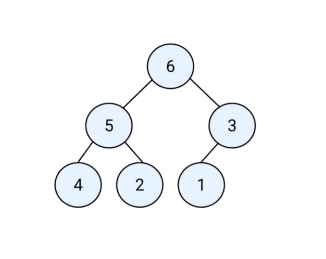
完全二叉树:每层节点都完全填满,在最后一层上如果不是满的,则只缺少右边相关节点
完全二叉树这个约束不是随便加的,它是堆能用数组存储的前提。因为节点从上到下、从左到右紧密排列没有空洞,所以可以按层序编号一一对应到数组下标,不需要存指针。
下图是完全二叉树的样子,注意最后一层是从左往右连续填的,中间不能空。
- 所有节点都大于等于(最大堆)或小于等于(最小堆)它的子节点
这一条要注意它约束的范围:只管父子之间的关系,不管兄弟之间。所以最小堆里根节点是全局最小,但第二层那两个节点谁大谁小是不确定的,同一层内部完全无序。这就是堆和二叉搜索树的根本区别——二叉搜索树是全局有序的,中序遍历能得到排好的序列;堆只保证了「根是极值」这一件事,整体是半有序的。
正因为约束松,维护成本才低。堆的插入和删除都是 O(log n),而取极值是 O(1)。如果需要的只是反复取最大或最小值,堆比排序划算得多:排序要 O(n log n) 而且每次改动都得重排。
JS 中的堆
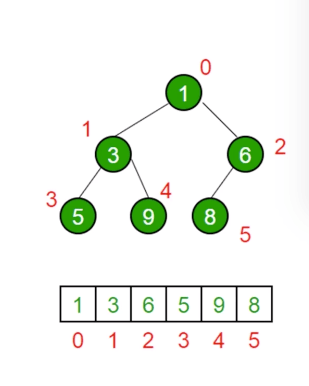
JS中通常用数组表示堆- 左侧子节点的位置
2 * index + 1 - 右侧子节点的位置
2 * index + 2 - 父节点的位置是
(index - 1) / 2
这三个公式是堆实现的核心。把树按层序编号存进数组后,父子关系可以直接由下标算出来,所以不需要 left、right 这些指针字段,省空间,而且数组连续存储对缓存友好,实际跑起来比指针版的树快。
推导也不难:下标 0 是根,它的孩子在 1 和 2,下标 1 的孩子在 3 和 4,下标 2 的孩子在 5 和 6。规律就是乘二加一和乘二加二。父节点的公式是子节点公式的逆运算,左右孩子算出来的父下标是同一个,因为整数除法把小数部分丢掉了。
父节点公式那条要注意取整。(index - 1) / 2 在 JS 里得到的是浮点数,不能直接当下标用,必须向下取整。下面代码里用的是 (i - 1) >> 1,右移一位等价于除以二并向下取整,写法更短。
下图展示了树形结构和数组下标的对应关系,可以对着验证上面几个公式。
用处
- 堆能高效、快速地找出最大值和最小值,时间复杂度:
O(1)
极值永远在根节点,也就是数组下标 0,直接取即可,这是 O(1) 的来源。但要分清「查看」和「取出」:查看是 O(1),取出之后要重新调整堆结构,那是 O(log n)。
- 找出第
K个最大(小)元素
这是堆最经典的应用,思路值得记一下。求第 K 大的元素,用一个容量为 K 的最小堆:遍历数据,堆没满就直接放进去,堆满了就拿当前元素跟堆顶比——堆顶是这 K 个里最小的,如果当前元素比它还小就直接丢掉,比它大就替换掉堆顶再调整。遍历完,堆里留下的就是最大的 K 个,而堆顶正是第 K 大。
注意这里求「第 K 大」用的是最小堆,这个反直觉的点是关键:堆顶是待淘汰的候选,用最小堆才能让最小的那个暴露在顶上方便被替换。
这个做法的价值在于复杂度和空间。整体是 O(n log k),比先全排序再取的 O(n log n) 更优,尤其 K 远小于 n 的时候。更重要的是空间只需要 O(k),数据可以流式地喂进来不必全部装进内存,处理海量数据时这是唯一可行的路子。
另外优先队列基本都是用堆实现的,任务调度里按优先级取任务、Dijkstra 算法里取当前最近的节点,用的都是这个结构。
JS 实现最小堆类
下面这个类只实现了插入的部分,够说明堆的核心机制。
class MiniHeap {
  constructor() {
    this.heap = [];
  }
  getParentIndex(i) {
    return (i - 1) >> 1;
  }
  shiftUp(index) {
    if (index == 0) return;
    const parentIndex = this.getParentIndex(index);
    if (this.heap[parentIndex] > this.heap[index]) {
      this.swap(parentIndex, index);
      this.shiftUp(parentIndex);
    }
  }
  insert(value) {
    this.heap.push(value);
    this.shiftUp(this.heap.length - 1);
  }
}
insert 的两步走很能体现堆的设计思路。第一步 push 到数组末尾,这一步保证了完全二叉树的形状不被破坏——末尾正好是下一个该填的位置。但新值可能比父节点小,违反了最小堆的性质,所以第二步 shiftUp 来修复。
shiftUp 做的是「上浮」:拿新节点跟父节点比,如果父节点更大就交换,然后站在新位置上继续跟新的父节点比,一直到父节点不再更大或者到达根节点。index == 0 就是到根了的终止条件。
这里的关键是只需要沿着一条路径往上走,不用管其他分支。因为堆的性质只约束父子关系,插入的新值只可能跟它的祖先链发生冲突,跟兄弟和其他子树无关。而完全二叉树的高度是 log n,所以最多交换 log n 次,这是插入 O(log n) 的来源。
shiftUp 用的是递归写法,也可以改成 while 循环,两者等价,循环版省掉函数调用开销。
补充说一下这个类没写的部分。删除堆顶要用到与上浮相反的「下沉」操作:先把数组最后一个元素挪到堆顶顶上位置,数组长度减一,然后从根开始往下比——跟两个孩子中较小的那个比,如果自己更大就交换并继续下沉。之所以要拿末尾元素来填,还是为了保持完全二叉树的形状不出现空洞。下沉同样只走一条路径,所以也是 O(log n)。
改成最大堆只需要把比较符号反过来,其余逻辑完全不变。要支持存对象而不只是数字,通常的做法是构造函数接收一个比较函数,把 > 换成调用比较函数,这样堆就跟具体的数据类型解耦了。
还没有留言,来发表第一条吧~