

百度搜索资源平台添加站点与验证
记录一下在百度搜索资源平台添加站点遇到的问题
您无权访问该页面,点击确定按钮返回首页
- 使用
chrome浏览器进行添加站点一直提示,您无权访问该页面,点击确定按钮返回首页 - 或者尝试退出登录,重新登录
解决方法: 更换了其他浏览器(如:火狐)
百度搜索资源平台站点地址:https://ziyuan.baidu.com/site#/
添加成功后文件验证
因为我需要添加到自己的网页当中所以选择 HTML 验证
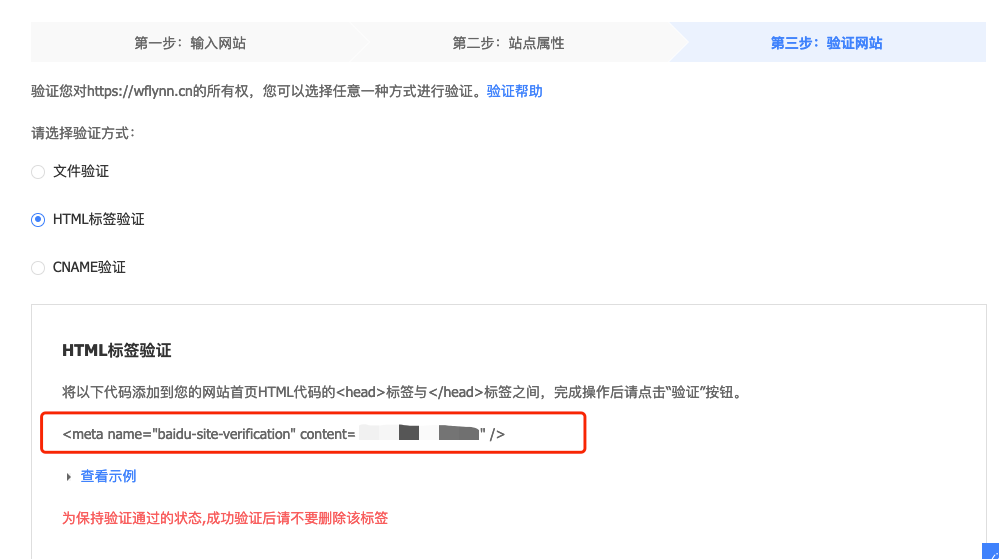
将上述获取到的代码添加到自己博客的 index.html 的 meta 头中
具体是一个这样的标签,放在 <head> 里:
<meta name="baidu-site-verification" content="code-xxxxxxxxxx" />
content 的值是百度给你的那一串,每个站点不同。放好之后部署上线,回到百度那边点「完成验证」,它会抓取你的首页去查这个 meta 标签。
三种验证方式怎么选
百度提供三种,各有适用场景:
文件验证 — 下载一个 baidu_verify_xxxx.html 放到网站根目录,验证时百度访问 https://你的域名/baidu_verify_xxxx.html 看内容对不对。适合能直接往服务器根目录放文件的情况。
对 Vite / Vue CLI 项目来说,这个文件要放在 public/ 目录下——public 里的文件会被原样复制到构建输出的根目录,不参与打包处理。放到 src/ 下是没用的,会被打包器当资源处理掉。
HTML 标签验证(本文用的) — 加一个 meta 标签。适合 SPA、或者不方便往根目录放文件的托管平台。
CNAME 验证 — 加一条 DNS 记录。适合站点还没上线、或者想验证整个域名(包括所有子域)的情况。这个方式的好处是不依赖网站内容,改一次 DNS 长期有效,网站怎么改都不影响。
我推荐 CNAME 验证,理由是它最稳。文件和 meta 标签这两种都依赖「网站能被百度抓到且内容正确」,一旦你重构了模板、换了框架、或者某次部署漏了这个文件,验证就失效,站点被移出资源平台,之前的收录数据也看不到了。DNS 记录不会因为代码变动而消失。
SPA 项目的 meta 标签怎么加才有效
这是本文最值得展开的技术点,因为加错位置会导致验证一直失败,而且原因不明显。
关键在于:百度的验证爬虫不执行 JavaScript(至少历史上不执行,现在也不能依赖它执行)。所以如果你用 JS 动态往 document.head 里插这个 meta 标签,爬虫抓到的 HTML 里根本没有它。
在 Vue / React 项目里,正确的位置是项目根目录的 index.html 模板文件,也就是构建工具用来生成最终 HTML 的那个源文件:
<!doctype html>
<html lang="zh-CN">
  <head>
    <meta charset="UTF-8" />
    <meta name="viewport" content="width=device-width, initial-scale=1.0" />
    <!-- 站长平台验证:这些是静态的,必须写在模板里 -->
    <meta name="baidu-site-verification" content="code-xxxxxxxxxx" />
    <meta name="google-site-verification" content="xxxxxxxxxx" />
    <meta name="msvalidate.01" content="XXXXXXXXXXXX" />
    <title>站点标题</title>
  </head>
  <body>
    <div id="app"></div>
    <script type="module" src="/src/main.ts"></script>
  </body>
</html>
错误的做法(这些都会验证失败):
// 错:用 vue-meta / @vueuse/head 动态添加,爬虫看不到
useHead({
  meta: [{ name: 'baidu-site-verification', content: 'code-xxx' }],
});

// 错:在 mounted 里手动插
onMounted(() => {
  const meta = document.createElement('meta');
  meta.name = 'baidu-site-verification';
  document.head.appendChild(meta);
});
验证之后可以自己确认爬虫能不能看到——用 curl 拉原始 HTML(不执行 JS,和爬虫的视角一致):
curl -s https://你的域名 | grep baidu-site-verification
有输出说明没问题;没输出就是标签在运行时才被插入的,爬虫抓不到。
「您无权访问该页面」的可能原因
正文提到换浏览器解决了,这个现象我遇到过,补充几个可能的原因,方便下次遇到时少走弯路:
Cookie 或 localStorage 里有脏数据。百度系服务共用一套登录态(.baidu.com 域下的 cookie),如果之前登录过别的百度服务、或者有过期的 session,可能导致资源平台的权限判断出错。换浏览器有效,本质上是换了一套干净的 cookie 环境。
所以不换浏览器的话,也可以试:
- 用无痕窗口(
Command/Ctrl + Shift + N)重新登录 - 或者在 DevTools 的
Application→Storage里对baidu.com执行Clear site data,然后重新登录
广告拦截插件干扰。资源平台的部分接口路径带 ad、stat 之类的关键词,容易被 uBlock、AdGuard 之类的规则误杀。请求被拦掉之后前端拿不到权限数据,就渲染成「无权访问」。这个原因很常见且很难想到——排查方法是开无痕窗口(默认禁用扩展)试一次。
账号本身的权限问题。百度资源平台的站点有「所有者」和「协作者」角色,如果这个站点是别人先添加的,你的账号可能只是被邀请但没接受。这种情况下换浏览器也解决不了,得看站点列表里有没有待处理的邀请。
验证成功之后该做什么
添加站点只是开始,真正影响收录的是后面这几步。既然文章讲的是站点添加,把后续的关键动作一起列出来:
1. 提交 sitemap
在「普通收录」→「sitemap」里提交你的站点地图地址:
https://你的域名/sitemap.xml
sitemap 是告诉搜索引擎「我有哪些页面」的标准方式。Vite 项目可以用 vite-plugin-sitemap 之类的插件在构建时生成,或者写个脚本遍历路由生成。格式最简:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://你的域名/</loc>
    <lastmod>2026-08-01</lastmod>
  </url>
  <url>
    <loc>https://你的域名/pages/50a676</loc>
    <lastmod>2026-08-01</lastmod>
  </url>
</urlset>
lastmod 要真实反映内容的最后修改时间。全部写成同一天、或者每次构建都刷成当天,会降低搜索引擎对这个字段的信任度。
2. 配好 robots.txt
放在网站根目录(同样是 Vite 项目的 public/):
User-agent: *
Allow: /
Disallow: /admin/

Sitemap: https://你的域名/sitemap.xml
在 robots.txt 里声明 sitemap 地址是个好习惯,所有搜索引擎都认这个约定,不用逐个平台提交。
检查 robots 有没有意外挡住内容:百度资源平台里有个「robots」检测工具,Google Search Console 里也有。这一步值得做,因为 Disallow 写错一个字符就可能把整站挡在外面,而症状是「一直不收录」,很难联想到 robots。
3. 主动推送(百度特有)
百度提供了实时推送接口,新文章发布后立刻推送,比等爬虫来抓快得多:
curl -H 'Content-Type:text/plain' \
  --data-binary @urls.txt \
  "http://data.zz.baidu.com/urls?site=https://你的域名&token=你的token"
urls.txt 里一行一个 URL。token 在资源平台的「普通收录」页面能看到。每天有配额上限,用完了要等第二天。
这个接口值得写进部署流程里——构建完成后自动把新增/修改的页面推送一遍。
4. SPA 的核心问题:内容能不能被抓到
这是决定一切的前提。如果你的博客是纯客户端渲染的 SPA,爬虫抓到的 HTML 就是一个空的 <div id="app">,没有任何内容。Google 现在能执行 JS 所以还好,百度对 JS 渲染的支持一直很有限,实际表现是大量页面收录不了或者只收录标题。
解决方向有三个:
- SSG(静态生成) — 构建时把每个页面渲染成完整的 HTML 文件。博客类站点最合适,因为内容是静态的。VitePress、Nuxt 的
generate、Astro 都是这个路线。 - SSR(服务端渲染) — 每次请求在服务端渲染。适合内容动态的站点,成本更高(需要 Node 服务)。
- 预渲染(prerender) — 用
vite-plugin-prerender之类的插件,构建时用无头浏览器跑一遍把 HTML 存下来。介于前两者之间,改造成本最低。
如果你的博客像本文提到的这样是 Vue SPA,且发现「验证通过了但一直不收录」,八成就是这个原因,而不是站点添加或者 sitemap 的问题。这一层不解决,前面几步做得再全也没用。
5. 同时提交给其它搜索引擎
百度之外值得配的还有:
- Google Search Console —
https://search.google.com/search-console,验证方式和百度类似(HTML 标签、DNS、文件)。对技术博客来说 Google 的流量通常比百度更有价值。 - Bing Webmaster Tools — 可以直接从 Google Search Console 导入站点,省一次验证。
- 必应之外还有神马(移动端)、头条搜索,视目标读者决定要不要配。
各家的 meta 验证标签互不冲突,都写在 <head> 里就行,一次改代码全部搞定。
还没有留言,来发表第一条吧~