

从输入 URL 到浏览器渲染页面的完整过程
先分析浏览器进程发生了什么
- 在浏览器进程中输入
url地址开始导航。并准备渲染进程 - 在网络进程中发送请求,将响应后的结果交给渲染进程处理
- 解析页面,加载页面中所需资源
- 渲染完毕,展示结果
URL 请求过程
- 浏览器查找当前
URL是否存在缓存,如果有缓存、并且缓存未过期,直接从缓存中返回。 - 查看域名是否已经被解析过了,没有解析过进行
DNS解析将域名解析成IP地址,并增加端口号 - 如果请求是
HTTPS,进行SSL协商 - 利用
IP地址进行寻址,请求排队。同一个域名下请求数量不能多余6个。 - 排队后服务器创建
TCP链接 (三次握手) - 利用
TCP协议将大文件拆分成数据包进行传输(有序传输),可靠的传输给服务器(丢包重传),服务器收到后按照序号重排数据包 (增加TCP头部,IP头部) - 发送
HTTP请求(请求行,请求头,请求体) HTTP 1.1中支持keep-alive属性,TCP链接不会立即关闭,后续请求可以省去建立链接时间。- 服务器响应结果(响应行,响应头,响应体),返回状态码为
301、302时,浏览器会进行重定向操作。(重新进行导航),返回304则查找缓存。(服务端可以设置强制缓存) - 浏览器接收
HTTP响应,然后根据情况选择关闭TCP连接或者保留重用,关闭TCP连接的四次握 - 浏览器检查响应状态码,如果资源可缓存,进行缓存,对响应进行解码(例如
gzip压缩),根据资源类型决定如何处理 - 当服务端返回的类型是
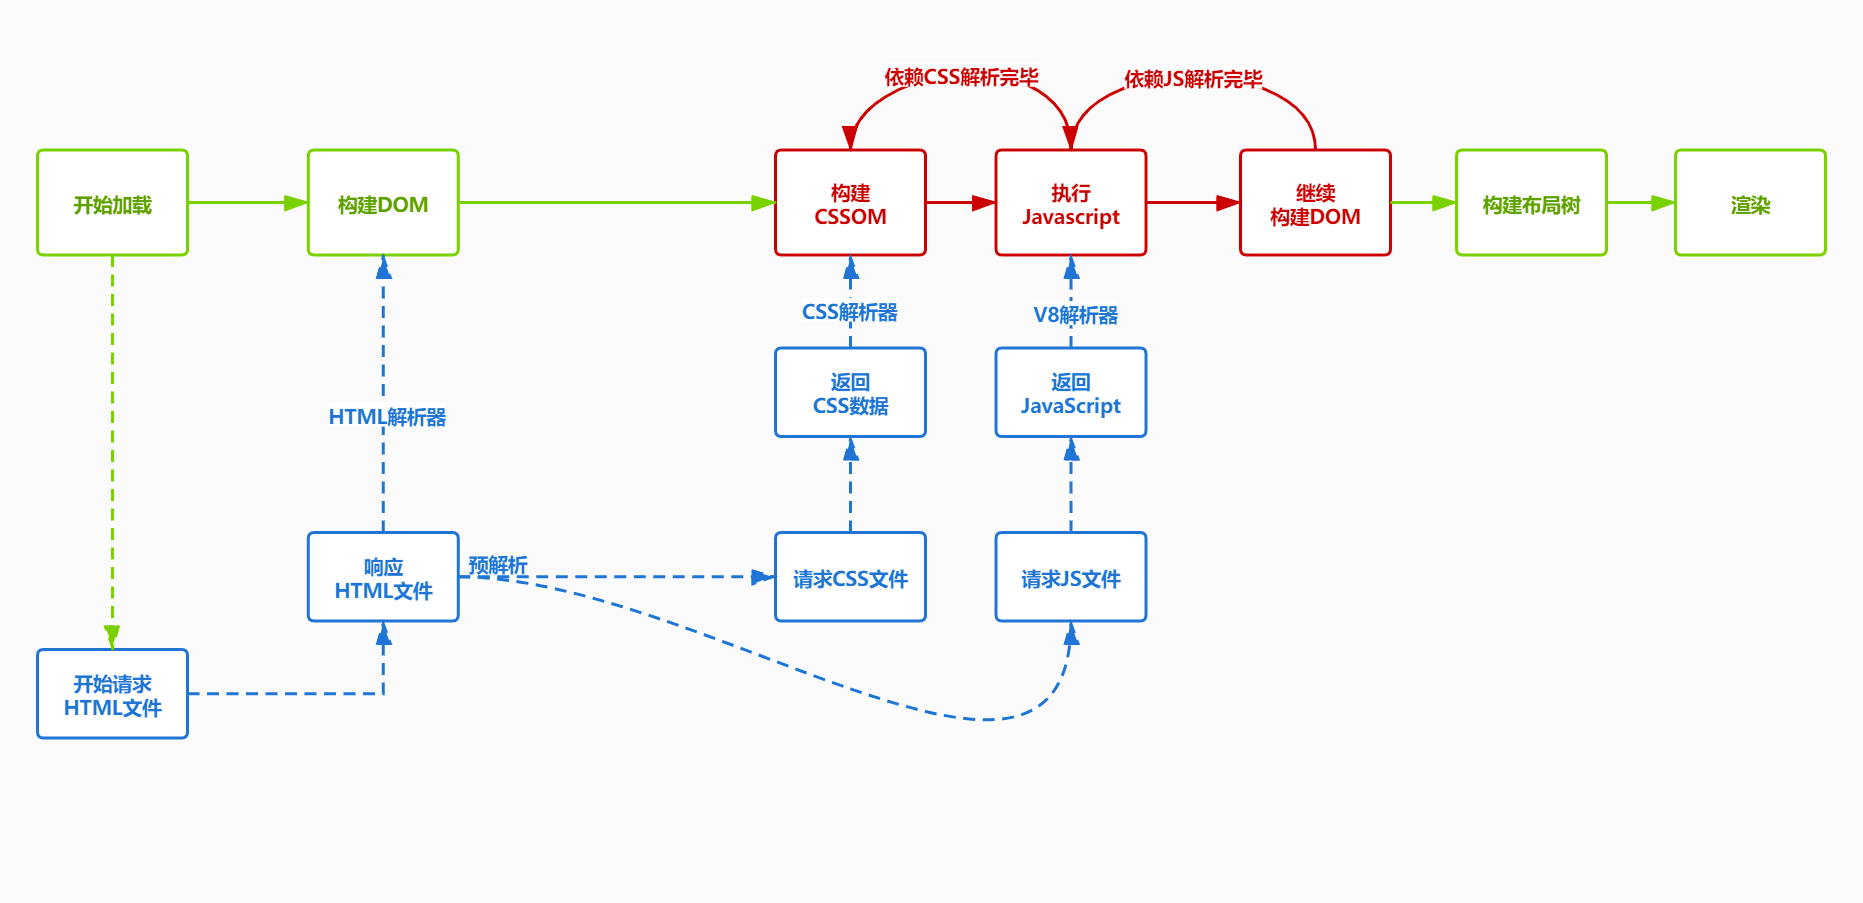
text/html时,浏览器会将收到的数据通过HTMLParser进行解析 (边下载边解析) - 在解析前会执行预解析操作,会预先加载
JS、CSS等文件 - 构建
DOM树:字节流 -> 分词器 ->Tokens-> 根据token生成节点 -> 插入到DOM树中 - 构建
CSSOM树 - 根据
DOM树和CSSOM树构建渲染树- 从
DOM树的根节点遍历所有可见节点,不可见节点包括:script,meta这样本身不可见的标签。被css隐藏的节点,如display: none - 对每一个可见节点,找到恰当的
CSSOM规则并应用 - 发布可视节点的内容和计算样式
- 从
- 遇到 js 的解析过程
HTML解析器遇到没有async和defer的script时,将他们添加到文档中,然后执行行内或外部脚本。这些脚本会同步执行,并且在脚本下载和执行时解析器会暂停。- 当解析器遇到设置了
async属性的script时,开始下载脚本并继续解析文档。脚本会在它下载完成后尽快执行,但是解析器不会停下来等它下载 - 所有
defer脚本会按照在文档出现的顺序执行,在HTML被构建完成时执行 - 浏览器在
Document对象上触发DOMContentLoaded事件 - 此时文档完全解析完成,浏览器可能还在等待如图片等内容加载,等这些内容完成载入并且所有异步脚本完成载入和执行
window触发load事件
通过 network Timing 观察请求发出的流程
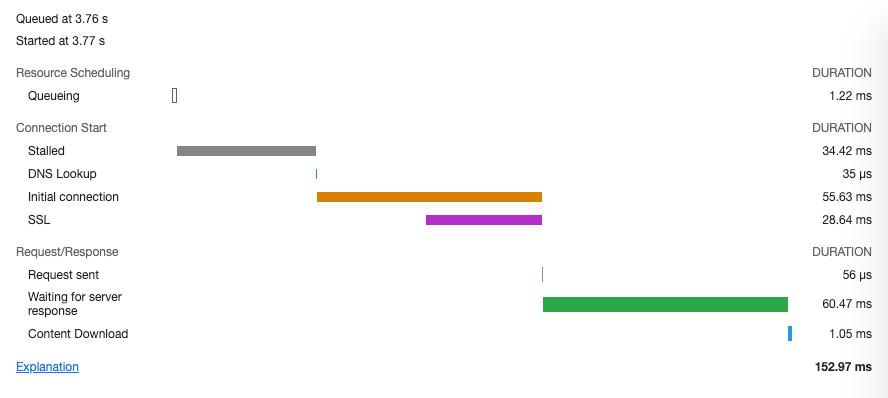
Queuing: 请求发送前会根据优先级进行排队,同时每个域名最多处理6个TCP链接,超过的也会进行排队,并且分配磁盘空间时也会消耗一定时间。Stalled: 请求发出前的等待时间(处理代理,链接复用)DNS lookup: 查找DNS的时间initial Connection: 建立TCP链接时间SSL:SSL握手时间(SSL协商)Request Sent: 请求发送时间(可忽略)Waiting(TTFB): 等待响应的时间,等待返回首个字符的时间Content Dowloaded: 用于下载响应的时间
蓝色:DOMContentLoaded: DOM 构建完成的时间 红色:Load: 浏览器所有资源加载完毕
渲染流程
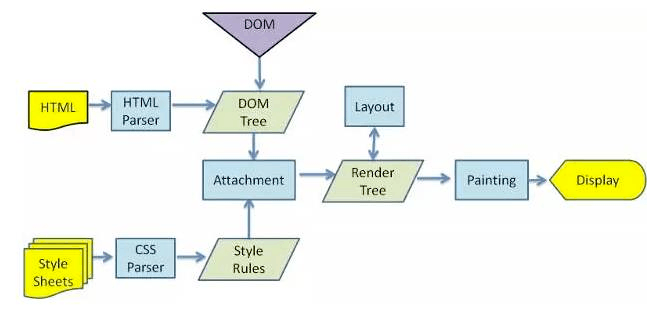
- 浏览器无法直接使用
HTML,需要将HTML转化成DOM树。(document) - 浏览器无法解析纯文本的
CSS样式,需要对CSS进行解析,解析成styleSheets,CSSOM(document.styleSeets) - 计算出
DOM树中每个节点的具体样式(Attachment) - 创建渲染
Layout布局树,将DOM树中可见节点,添加到布局树中。并计算节点渲染到页面的坐标位置。(layout) - 通过布局树,进行分层(根据定位属性、透明属性、
transform属性、clip属性等)生成图层树 - 将不同图层进行绘制,转交给合成线程处理。最终生成页面,并显示到浏览器上 (
Painting,Display)
Performance 网页渲染绘制分析
如下代码,我们看下 Performance 下绘制的分析
<!DOCTYPE html>
<html>
  <head>
    <meta charset="UTF-8" />
    <title>测试</title>
  </head>
  <body>
    <div>1</div>
  </body>
</html>
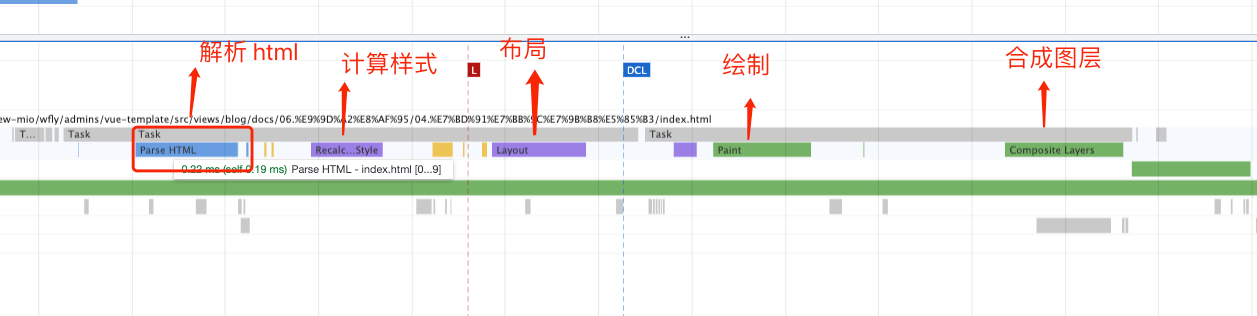
分析如图所示
Parse Html: 解析htmlRecalculated Style: 计算每个DOM的样式结果Layout: 在上两个阶段结束后会生成一个储存其计算结果的树结构LayoutObject Tree,在这个阶段浏览器会遍历LayoutObject Tree计算每个节点在页面上具体的布局,计算文本实际宽高等,重排就是在这一阶段进行Pre-paint: 判断与上一次paint阶段相比有哪些内容需要被更新,二是构建property trees,property trees的property是指translation,scale等需要大量计算的属性。将这些属性抽离出来单独管理,避免父元素的变动导致其子元素上所有的属性都有全部重新计算。Paint: 绘制阶段,也是我们常说的重绘阶段,但这一阶段并不是执行实际的页面绘制,而是依据页面内容的层叠顺序生成绘制任务列表,主线程的任务到这里基本结束,将绘制列表提交到合成线程Composite Layers: 合成图层
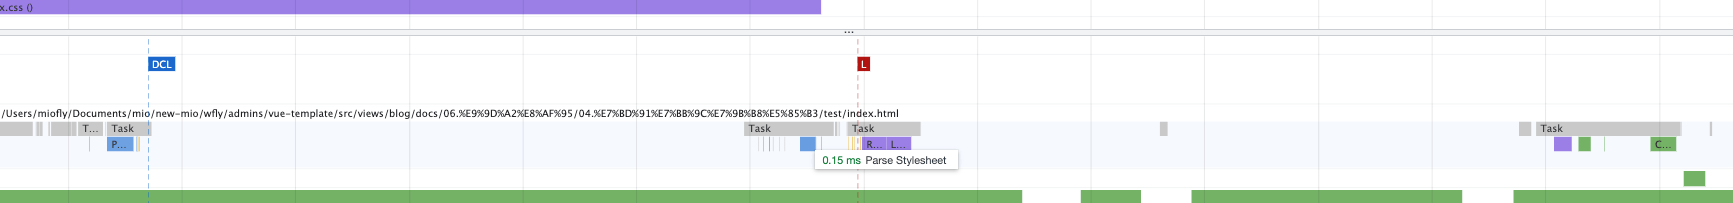
这时我们引入一个 css 文件
<!DOCTYPE html>
<html>
  <head>
    <meta charset="UTF-8" />
    <title>测试</title>
    <link rel="stylesheet" href="./index.css" />
  </head>
  <body>
    <div>1</div>
  </body>
</html>
会发现有一个解析 stylesheet 的过程
为什么要把 css 文件的引入放到上面呢
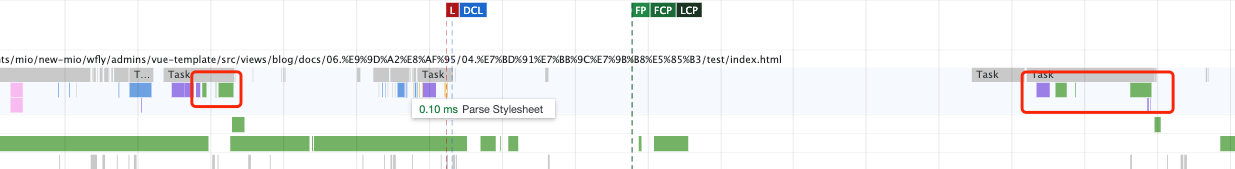
如下代码我们将 link 引入的 css 放到了 div 下面
<!DOCTYPE html>
<html>
  <head>
    <meta charset="UTF-8" />
    <title>测试</title>
  </head>
  <body>
    <div>1</div>
    <link rel="stylesheet" href="./index.css" />
  </body>
</html>
看下图的分析,可以发现,在解析 stylesheet 时,已经完成了一次绘制,解析完 stylesheet 后又进行了一次绘制。 由于解析过程是由上而下的,所以为了避免不必要的重绘,应该把 css 的引入放到上面
Js 为什么要放到底部加载呢
<!DOCTYPE html>
<html>
  <head>
    <meta charset="UTF-8" />
    <title>测试</title>
  </head>
  <body>
    <div>1</div>
    <script>
      let n = 1;
      for (let i = 0; i < 100000000; i++) {
        n += i;
      }
    </script>
    <div>2</div>
  </body>
</html>
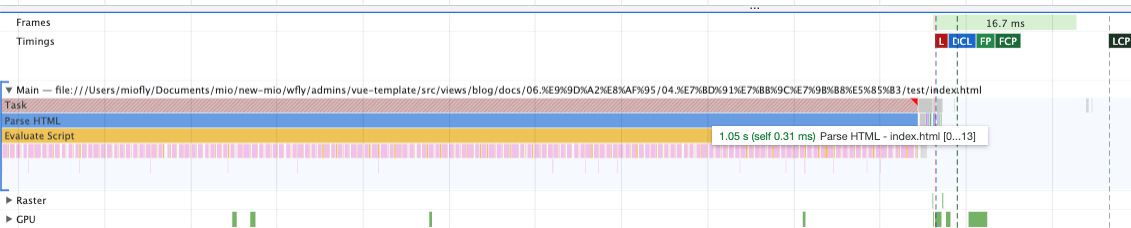
如下图所示,我们在 body 中加入了一段 js 代码,然后我们可以看到 parse html 的时间为 1.05s,这是由于下面的 js 代码执行消耗造成的
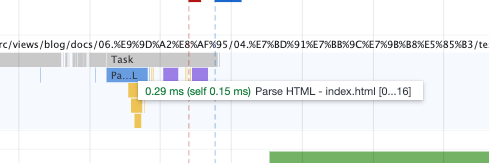
然后我们把里面的 script 代码去除掉,如下图可以发现 parse html 的时间为 0.29s,所以很直观的可以发现内联的 script 代码会阻塞 html 的解析,同时也会阻碍加载
如何优化
网络优化策略
- 减少
HTTP请求数,合并JS、CSS,合理内嵌CSS、JS - 合理设置服务端缓存,提高服务器处理速度。 (强制缓存、对比缓存)
- 避免重定向,重定向会降低响应速度 (
301,302) - 使用
dns-prefetch,进行DNS预解析 - 采用域名分片技术,将资源放到不同的域名下。接触同一个域名最多处理
6个TCP链接问题 - 采用
CDN加速加快访问速度。(指派最近、高度可用) gzip压缩优化 对传输资源进行体积压缩 (html,js,css)- 加载数据优先级 :
preload(预先请求当前页面需要的资源)prefetch(将来页面中使用的资源)将数据缓存到HTTP缓存中
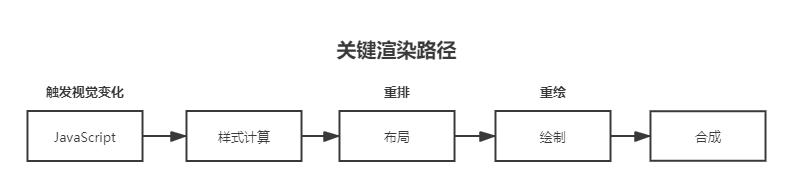
重排重绘
- 重排(回流)
Reflow: 添加元素、删除元素、修改大小、移动元素位置、获取位置相关信息 - 重绘
Repaint:页面中元素样式的改变并不影响它在文档流中的位置。
如下代码,我们在函数中使用了 app.offsetHeight 来获取 app 元素的 offsetHeight 属性,这一步就会导致重排。
为什么获取元素的 offsetHeight 会导致重排呢,那是因为即使 dom 构建完毕,但是当我们去使用 js 去获取元素相关位置等信息时, 之前没有相关的信息被记录下来,这时候浏览器只能进行一次重排,然后获取到当前元素的信息,进而给到使用者。
<div id="app"></div>
<script>
  function reflow() {
    let el = document.getElementById('app');
    let node = document.createElement('h1');
    node.innerHTML = 'hello';
    el.appendChild(node);
    // 强制同步布局
    console.log(app.offsetHeight);
  }
  requestAnimationFrame(reflow);
</script>
再看如下代码,我们在 reflow 中获取了元素的 offsetHeight,同时加入了一个循环监听,这就会导致浏览器反复执行布局操作造成布局抖动
function reflow() {
  let el = document.getElementById('app');
  let node = document.createElement('h1');
  node.innerHTML = 'hello';
  el.appendChild(node);
  // 强制同步布局
  console.log(app.offsetHeight);
}
window.addEventListener('load', function () {
  for (let i = 0; i < 100; i++) {
    reflow();
  }
});
优化方法
- 脱离文档流
- 渲染时给图片增加固定宽高
- 尽量使用
css3动画 - 可以使用
will-change提取到单独的图层中
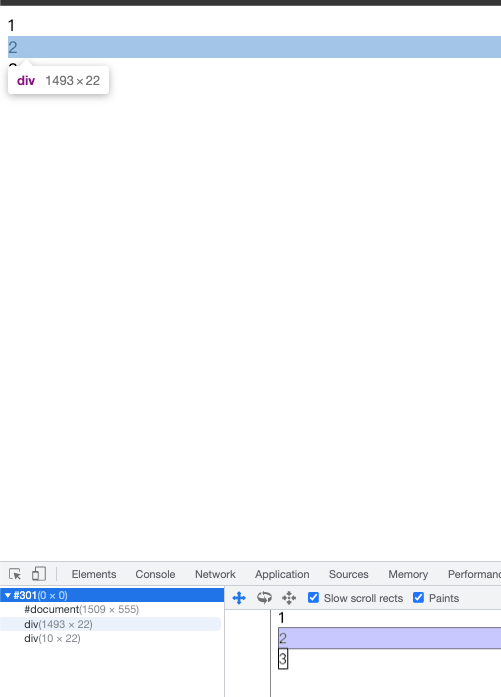
图层
<!DOCTYPE html>
<html>
  <body>
    <div>1</div>
    <div style="will-change: transform">2</div>
    <div style="position: fixed">3</div>
  </body>
</html>
如上代码,我们查看 chrome 的 layer 示例,可以发现 will-change: transform 和 position: fixed 的元素都单独建立了一个图层
CSS 优化
- 减少伪类选择器、减少样式层数、减少使用通配符
- 避免使用
CSS表达式,CSS表达式会频繁求值, 当滚动页面,或者移动鼠标时都会重新计算 (IE6,7) - 删除空行、注释、减少无意义的单位、
css进行压缩 - 使用外链
css,可以对CSS进行缓存 - 添加媒体字段,只加载有效的
css文件 - 减少
@import使用,由于@import采用的是串行加载
JS 优化
- 通过
async、defer异步加载文件 - 减少
DOM操作,缓存访问过的元素 - 操作不直接应用到
DOM上,而应用到虚拟DOM上。最后一次性的应用到DOM上 requestAnimationFrame、requestIdleCallback- 尽量避免使用
eval, 消耗时间久 - 使用事件委托,减少事件绑定个数。
- 尽量使用
canvas动画、CSS动画 - 当需要设置的样式很多时设置
className而不是直接操作style - 虚拟滚动
对于 async、defer 的理解
由于 html 的解析是由上到下的,所以当遇到 script 标签时,就会停止解析,下载 js 然后执行,执行完毕后继续解析,这就导致我们需要把 script 标签放到 html 的最下方,等到 dom 解析完毕,再去执行 js,才能实现 hmtl 的解析不被 js 阻塞。
为了解决 script 标签必须放到底部的问题,那么可以对 script 标签添加 async、defer 属性
defer
- 当浏览器解析遇到带有
defer标签的script时,浏览器继续往下面解析页面,且会并行下载script标签的外部js文件 - 解析完
HTML页面,再执行刚下载的js脚本 defer脚本会在文档渲染完毕后DOMContentLoaded事件调用前执行,即刚刚解析完,且可保证执行顺序就是他们在页面上的先后顺序DOMContentLoaded事件的触发时机为初始HTML被构建完成时,此时CSS、图片等资源不需要加载完,但我们的脚本要执行完。- 如果多个
script设置了defer属性,这几个script的执行顺序和声明顺序相同,即最前面的脚本先执行。 - 内置
js代码的script标签,以及动态生成的script标签,defer属性不生效
async
- 当浏览器解析遇到带有
async属性的script标签,会继续往下解析,并且同时另开进程下载脚本 - 脚本下载完毕,浏览器停止解析,开始执行脚本,执行完毕后继续往下解析
- 设置
async后,脚本一旦被下载好了就会执行,不管什么时机,所以执行顺序就是谁先下载好谁先执行 - 虽然
async的加载是异步执行的,由于async是只要加载好就执行,所以async的执行阶段会打断页面解析
还没有留言,来发表第一条吧~